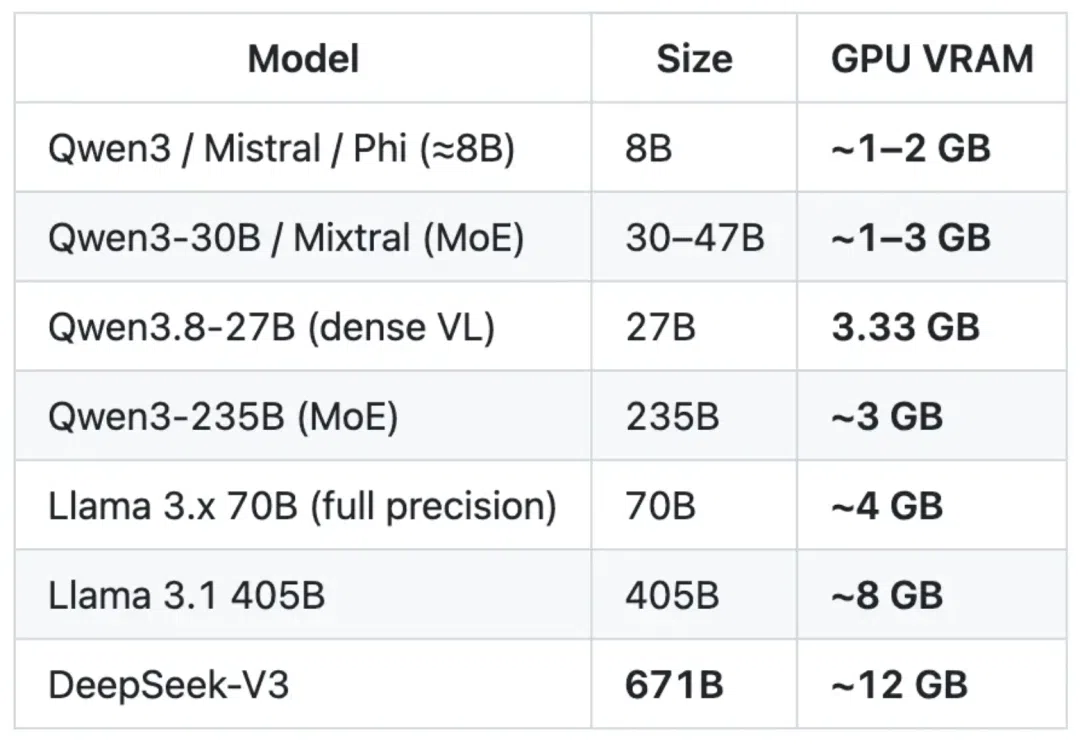
airllm:4GB 显存跑 70B 模型
网上看到的方案,记一下。核心思路是分层加载(layer-wise loading),不靠量化、蒸馏、剪枝,把模型权重按层放 CPU/GPU 之间倒腾,推理时只保留当前层在显存里。作者的说法是 4GB 显存就能跑 70B 级模型。
已验证的要点:
- 支持架构:Llama 3.x、Qwen3、DeepSeek 这几个主流系列
- 附带能力:预取加速(prefetch,减少层切换等待)、8bit/4bit 量化开关、macOS 可跑
- 仓库位置:
https://github.com/lyogavin/airllm
边界与存疑点:
- 原文说"无需量化、蒸馏或剪枝",但后面又提支持 8bit/4bit 量化,我理解是"4GB 跑 70B 不依赖量化",量化只是可选项。两者具体关系原文未展开。
- 只说"4GB 显存",没区分最小显存和推荐显存,也没给 batch size、seq len 之类的约束条件。实际能跑多大多长序列,得自己试。
- 是推理库不是训练库,别拿来训模型。
顺手收藏的链接
- 分享一个无代码 AI 开源 BI 平台
- Star 6.3k AI 工作流引擎 FlowLong 1.2.6 发布
- openai 把 codex 开源了 Star 112k
- DeepSeek V4 Pro正式版 + Harness 开源 100k Star
- 企业 AI 网关 apipig 玩转 AI 代码评审
几个链接都是昨天整理时攒下的,具体细节没来得及细看,先留档再说。