程序员茄子
全部
编程
代码
资讯
案例
综合
联系我们
大模型 相关技术文章
php
mysql
shell
go
vue
css
api接口对接
支付接口对接
资讯
AI 短剧自动化生产,开源新选择 Huobao Drama:本地部署,剧本到成片全流程
2026-09-13 12:35:11
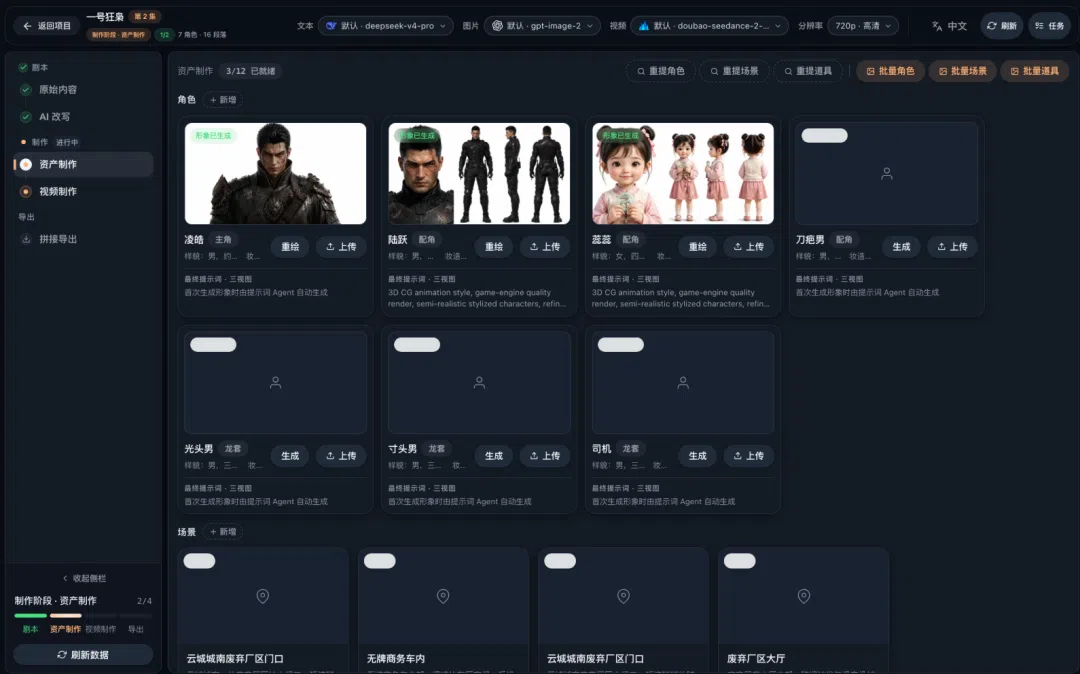
Huobao Drama 是开源的 AI 短剧自动化生产平台,用大模型解析剧本、AI 绘图生成角色与场景、文生/图生视频出分镜,FFmpeg 合成字幕并整集导出。本文按角色管理、视频任务、视频生成、资源管理四块梳理它的能力与工作流,附 GitHub 地址。
AI短剧
开源项目
视频生成
FFmpeg
大模型
阿里除夕开源 Qwen3.5:397B 总参数仅激活 17B,硬刚顶级闭源模型
资讯
阿里除夕开源 Qwen3.5:397B 总参数仅激活 17B,硬刚顶级闭源模型
2026-09-12 09:48:40
阿里通义除夕开源 Qwen3.5-397B-A17B:MoE+线性注意力架构,每次推理仅激活 17B 参数,性能对标 GPT-5.2 与 Gemini 3 Pro,支持 1M 上下文、201 种语言与原生多模态,解码吞吐量是 Qwen3-Max 的 19 倍。
Qwen3.5
大模型
MoE
多模态
阿里开源
HuggingFace Transformers v5.15.0 发布解读:新增 Muse Glimmer 与 Granite SWA 系列支持
编程
HuggingFace Transformers v5.15.0 发布解读:新增 Muse Glimmer 与 Granite SWA 系列支持
2026-09-09 09:35:54
HuggingFace Transformers v5.15.0 发布:新增 Meta Muse Glimmer 多模态模型(30B、Apache 2.0、agent 场景)与 IBM GraniteMoeSWA/GraniteSWA 滑窗注意力变体支持,本地部署与长上下文场景可用。
Transformers
机器学习
大模型
开源库
KVMem:把百万 token 的 agent 工作区虚拟化到消费级 GPU 上
编程
KVMem:把百万 token 的 agent 工作区虚拟化到消费级 GPU 上
2026-09-07 18:12:29
arXiv 新作:把 agent 工作区历史作为分页 KV 状态跨显存/内存/磁盘换页,避免摘要丢证据与重复预填充。面向消费级 GPU 的长会话 agent 部署。
AI
大模型
KV cache
agent
VS Code 支持自带大模型密钥(BYOK):用自己的 API key 接入 Chat
编程
VS Code 支持自带大模型密钥(BYOK):用自己的 API key 接入 Chat
2026-09-07 11:18:35
VS Code 新增 BYOK:用自有 API key 接入 Azure、Anthropic、Gemini、OpenAI、OpenRouter 或 Ollama 本地模型,直接在 Chat 模型选择器使用。不占 Copilot 配额,支持完全离线场景。
VS Code
大模型
开发工具
Gemini 3.8 Flash 与 3.8 Flash Cyber 发布:更强的推理编码与网络安全模型
资讯
Gemini 3.8 Flash 与 3.8 Flash Cyber 发布:更强的推理编码与网络安全模型
2026-09-07 07:12:42
Google 发布 Gemini 3.8 Flash(六周内第三个 Flash,最强推理编码模型,DeepSWE 超大多数更大前沿模型)与 3.8 Flash Cyber(漏洞发现成功率超 70%、修补达前沿的网络安全模型),定价不变。
Google
Gemini
大模型
AI编码
网络安全
Agent
KotlinLLM 开源:把运行时逻辑委托给大模型的 IntelliJ 插件原型
编程
KotlinLLM 开源:把运行时逻辑委托给大模型的 IntelliJ 插件原型
2026-09-07 05:14:05
JetBrains Research 开源 KotlinLLM:IntelliJ 插件让 Kotlin 代码将运行时逻辑委托给大模型,Smart macros 生成并持久化 Kotlin 源码(asLlm/mockLlm),显式、持久、可移植,评估 24/24 场景完成、约 1% 开销。
KotlinLLM
Kotlin
大模型
LLM
IntelliJ
JetBrains
开源
Hugging Face Transformers v5.16.0 发布:新增 Qwen4-Exp、Granite Speech 5.0 与 Step-3.7-Flash 支持
资讯
Hugging Face Transformers v5.16.0 发布:新增 Qwen4-Exp、Granite Speech 5.0 与 Step-3.7-Flash 支持
2026-09-07 03:11:58
Hugging Face Transformers v5.16.0 发布:新增 Qwen4-Exp(线性+稀疏注意力混合架构)、Granite Speech 5.0 Turbo CTC(4.7 亿参数轻量 ASR)和 Step-3.7-Flash(198B 稀疏 MoE 视觉语言模型)支持,共 114 个提交。
HuggingFace
Transformers
Qwen4
语音识别
MoE
大模型
视觉语言模型
MAI-Code-1-Flash:微软自研编码模型在 VS Code 真实开发工作流中的早期成果
编程
MAI-Code-1-Flash:微软自研编码模型在 VS Code 真实开发工作流中的早期成果
2026-09-06 18:15:56
VS Code团队介绍微软自研编码模型MAI-Code-1-Flash在真实开发者工作流中的早期评估结果。MAI-Code-1-Flash定位于高速低成本编码模型,与VS Code的Coding Harness深度集成。评估方法不同于标准基准测试,在真实代码库、真实任务、真实工具和真实指标环境中评估,涵盖代码质量、任务完成率、迭代效率、工具使用效率、延迟和成本等维度。早期成果显示在代码生成质量、多步骤任务完成率、成本效益和延迟表现方面均表现良好。适用于实时代码补全、代码生成、代码重构、调试辅助和大规模批量任务。代表微软在AI编码助手领域的自研布局。
MAI-Code
微软
VS Code
编码模型
AI编码
Coding Harness
大模型
代码生成
揭秘 LLM 上下文窗口:AI 记忆如何工作以及为什么会失效
编程
揭秘 LLM 上下文窗口:AI 记忆如何工作以及为什么会失效
2026-09-06 05:13:46
文章深入探讨大语言模型上下文窗口的工作原理和失效原因。介绍了上下文窗口的组成(系统提示词、对话历史、当前输入、生成输出)、工作原理(Token化、注意力机制、位置编码、KV缓存),以及失效的六大原因(中间迷失、注意力稀释、位置编码外推、KV缓存管理、训练数据影响、提示词工程影响)。还提供了改善方法(提示词优化、上下文管理、RAG、微调、选择合适模型)和未来发展方向。
LLM
上下文窗口
Context Window
注意力机制
RAG
大模型
AI记忆
提示工程
Nvidia PAIR:用普通电脑搭建本地 AI 推理集群的免费工具
编程
Nvidia PAIR:用普通电脑搭建本地 AI 推理集群的免费工具
2026-09-06 05:13:45
Nvidia推出PAIR免费软件工具,允许用户使用同一网络中的多台独立电脑构建AI推理集群。文章介绍了本地AI计算的挑战(硬件资源分散、集群搭建复杂、模型推理资源需求、云端API局限)、PAIR的核心功能(节点管理、模型管理、统一推理API、监控日志、安全访问控制)、技术架构(网关+节点代理+调度器+模型存储)、使用方法(安装、配置集群、部署模型、使用推理API),以及与云端API和传统集群方案的对比。
Nvidia
PAIR
AI集群
本地推理
GPU
开源工具
边缘计算
大模型
前沿 LLM API 价格五个月未动,8 月却变动三次:一家实验室将费率提高了两倍
资讯
前沿 LLM API 价格五个月未动,8 月却变动三次:一家实验室将费率提高了两倍
2026-09-06 03:11:18
前沿LLM API价格在5个月稳定后,8月份发生了三次显著变动:一家实验室降价、另一家调整定价结构、第三家将费率提高两倍。文章分析了价格结构性粘性的原因、三次变动的具体情况和背景,以及对LLM定价趋势的重新思考(价格分化加剧、定价结构灵活化、成本透明度提升、价格战可能到来),并给出了开发者和企业的应对建议。
LLM
API定价
大模型
AI
价格趋势
成本优化
多模型策略
开源模型
Claude Fable 5 与 Opus 4.8:2026 年完整指南
编程
Claude Fable 5 与 Opus 4.8:2026 年完整指南
2026-09-06 02:13:04
Claude Fable 5自2026年6月发布以来成为软件工程团队讨论焦点,被认为是Anthropic最强大的推理引擎。文章详细介绍了Fable 5的核心能力(深度推理/长上下文/工具使用和Agent/代码生成)、技术特点和适用场景,Opus 4.8的核心能力和适用场景,两者的关键差异对比和选择建议,以及使用最佳实践(提示词优化/长上下文使用/工具使用/成本优化)。
Claude
Anthropic
Fable 5
Opus 4.8
大模型
AI
推理
LLM
Tree of Thoughts 与 MCTS 在 LLM 中的应用:当模型不再只猜一次时会发生什么
编程
Tree of Thoughts 与 MCTS 在 LLM 中的应用:当模型不再只猜一次时会发生什么
2026-09-06 02:13:03
传统LLM推理是让模型一次性猜答案,而Tree of Thoughts和MCTS让模型能探索多条推理路径、评估中间结果、选择最优路径。文章详细介绍了ToT的核心思想(思维分解/生成/评估/搜索)、MCTS的四个步骤(选择/扩展/模拟/回溯)、两者的区别和结合方式、实际应用场景(数学推理/代码生成/规划决策/科学发现),以及实现挑战和注意事项。
Tree of Thoughts
MCTS
LLM
推理
蒙特卡洛树搜索
AI
大模型
提示工程
OpenAI 推出 GPT-6 Astra:面向 ChatGPT、API、Azure 和 AWS Bedrock 的新一代模型
资讯
OpenAI 推出 GPT-6 Astra:面向 ChatGPT、API、Azure 和 AWS Bedrock 的新一代模型
2026-09-06 01:12:45
OpenAI推出GPT-6 Astra新一代智能模型,采用分阶段部署策略:先面向组织有限推出,随后扩展到ChatGPT消费版和主要云平台(Azure OpenAI Service、AWS Bedrock)。文章介绍了Astra命名含义、核心能力提升(推理、上下文理解、多模态、工具使用、代码生成)、部署平台,以及对开发者的影响和注意事项。
OpenAI
GPT-6
Astra
大模型
ChatGPT
Azure
AWS Bedrock
API
自托管 AI 栈七个月:四个值得记录的 Bug
编程
自托管 AI 栈七个月:四个值得记录的 Bug
2026-09-06 00:15:09
开发者分享团队自托管AI栈七个月的经历,原以为一个周末搞定最终花了七个月,2100次提交。文章记录四个Bug:模型加载时的GPU内存碎片化、推理服务的请求饥饿、向量数据库HNSW索引损坏、模型版本切换时的状态不一致,以及对应的解决方案和经验教训。
自托管
AI栈
大模型
GPU内存
向量数据库
推理服务
Bug排查
基础设施
Google 修复 Gemini 3.8 Flash AI 模式引用缺失 Bug
资讯
Google 修复 Gemini 3.8 Flash AI 模式引用缺失 Bug
2026-09-05 23:15:22
Google修复了Gemini 3.8 Flash在AI模式下的引用缺失Bug:部分AI生成回答没有附带引用或来源链接。问题在推出Gemini 3.8 Flash后不久被发现,影响用户对AI内容的可信度判断。Google通过模型微调和后处理修复了问题。文章分析了可能的技术原因(模型架构限制、引用生成复杂性、训练数据偏差、后处理Bug),并对AI搜索行业提出启示。
Google
Gemini
AI搜索
引用
Bug修复
大模型
AI模式
可信度
在 3.2GB 显存上微调 1.7B 模型:FineTune Studio 的构建实践
编程
在 3.2GB 显存上微调 1.7B 模型:FineTune Studio 的构建实践
2026-09-05 22:15:52
开发者分享构建 FineTune Studio 的经历——一个让普通人在消费级显卡上微调大语言模型的开源工具。核心技术是 QLoRA(4-bit量化+低秩适配+分页优化器),配合梯度检查点、CPU卸载、8-bit优化器等显存优化技巧,在3.2GB显存上完成1.7B模型微调。
大模型
微调
QLoRA
FineTune Studio
LLM
开源
低显存
AI
HuggingFace Transformers v5.14.0 发布:支持 Inkling 多模态大模型(975B 参数)
编程
HuggingFace Transformers v5.14.0 发布:支持 Inkling 多模态大模型(975B 参数)
2026-09-05 20:44:56
HuggingFace 发布 Transformers v5.14.0,新增对 Thinking Machines 公司 Inkling 模型的支持。Inkling 是通用多模态 MoE 模型,总参数 975B、激活参数 41B,支持文本、图像、音频输入和文本输出。
HuggingFace
Transformers
Inkling
大模型
多模态
MoE
AI
深度学习
AI Agent 规模化的经济学:Token、ROI 与平台构建
编程
AI Agent 规模化的经济学:Token、ROI 与平台构建
2026-09-05 20:29:57
当运行几十上百个 AI Agent 时,模型本身很少是瓶颈,真正困难的是用最少上下文获得可靠结果并控制成本。文章探讨 token 经济学、成本结构、ROI 衡量指标和 Agent 平台化的必要性。
AI Agent
大模型
Token
ROI
平台化
成本优化
规模化
LLM
system_prompts_leaks:收录140+ AI模型系统提示词的档案馆,4.6万Star
编程
system_prompts_leaks:收录140+ AI模型系统提示词的档案馆,4.6万Star
2026-09-05 19:02:52
介绍system_prompts_leaks这个GitHub仓库:专门收集和发布各大AI模型的出厂系统提示词,覆盖Claude、GPT、Gemini、Grok、Copilot、Cursor等二十多家公司140多个文件,提供版本Diff对比功能,还记录了Claude Code源码泄露和Anthropic双标争议等事件。
system_prompts_leaks
系统提示词
AI透明性
Prompt
大模型
腾讯混元 Hy4 preview 发布并开源:770B 参数、1M 上下文
资讯
腾讯混元 Hy4 preview 发布并开源:770B 参数、1M 上下文
2026-09-05 14:09:38
腾讯混元发布并开源新一代大语言模型 Hy4 preview:总参数 770B、激活参数 49B、上下文 1M tokens,定位为生产力而生。文章梳理核心参数、能力亮点、开源与接入方式、定价策略及行业背景。
腾讯混元
大模型
开源
MinerU-Popo:4B 后处理模型把跨页 OCR 拼回文档树,TEDS 53.7→90.6
编程
MinerU-Popo:4B 后处理模型把跨页 OCR 拼回文档树,TEDS 53.7→90.6
2026-09-03 18:45:07
MinerU 团队开源的 MinerU-Popo 是 4B 参数的 OCR 后处理模型,负责把跨页被切碎的表格、段落、标题层级和图文关系重新拼成文档树,五家主流 OCR 的标题层级 TEDS 从 50-60 分冲到 80 分以上。本文拆解它的数据引擎、动态分块与文档富化三招原理及成本账。
MinerU-Popo
OCR
文档解析
RAG
大模型
星火 X2.5 端侧模型发布:4B/1.7B 参数、百万上下文与 MOPD 蒸馏怎么看
资讯
星火 X2.5 端侧模型发布:4B/1.7B 参数、百万上下文与 MOPD 蒸馏怎么看
2026-09-02 20:37:02
梳理词元星火 9 月发布的端侧开源模型 Spark X2.5(4B/1.7B):评测数据、百万 token 混合注意力、MOPD 在线蒸馏、BF16 体积与部署栈兼容性,并对营销宣称做了标注。
AI模型
端侧推理
大模型
开源权重
工具调用
大家都在搜索什么?
devops
易支付
一个官网+多少钱
统一接受回调
统一回调
python
sub
node
宝塔日志
mysql
shell
ElasticSearch
css
vue
api接口对接
2025
支付接口对接
go
php
php回调
上一页
1
2
3
4
5
下一页
共 5 页
到第
页
确定