程序员茄子
全部
编程
代码
资讯
案例
综合
联系我们
大模型 相关技术文章(第2页)
php
mysql
shell
go
vue
css
api接口对接
支付接口对接
编程
airllm:4GB 显存跑 70B 模型的分层加载方案
2026-08-30 19:53:38
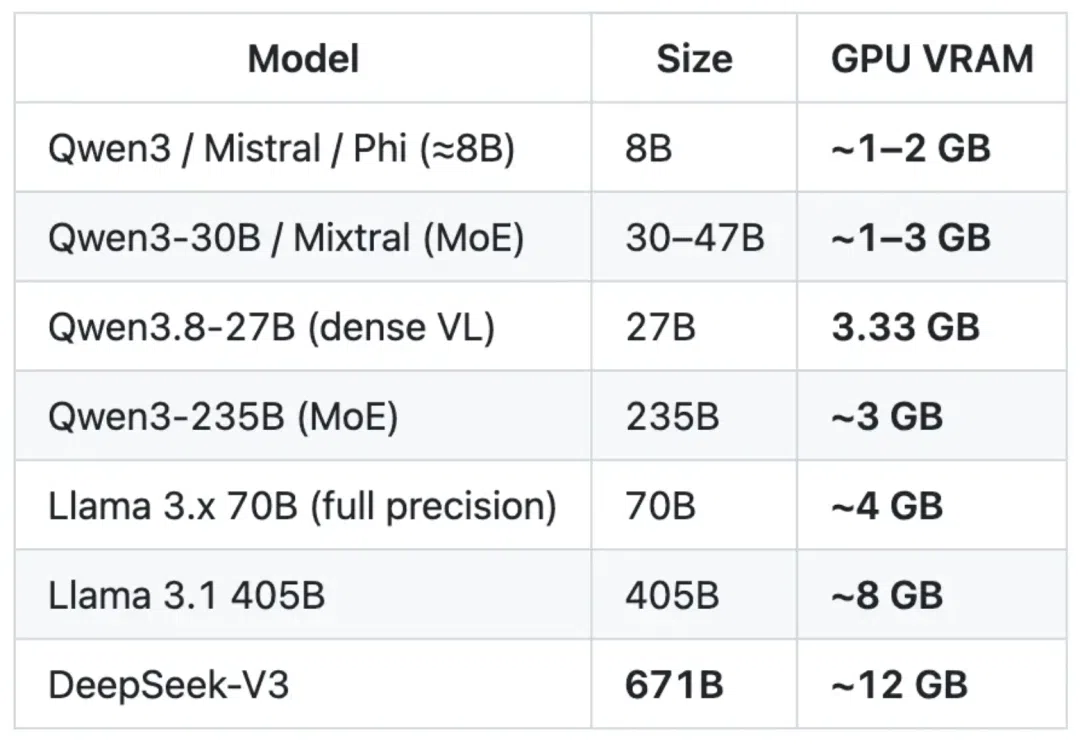
介绍 airllm 的分层加载方案:不靠量化蒸馏,把权重按层在 CPU/GPU 间倒腾,4GB 显存即可推理 70B 模型。讲清原理、适用场景与取舍。
airllm
大模型
推理
显存优化
MoE 路由为什么不稳定,以及怎么稳定
编程
MoE 路由为什么不稳定,以及怎么稳定
2026-08-30 15:21:47
MoE 路由为什么总不稳定:路由波动有具体数字(40.9% token 训练 20% 仍无稳定目标专家),路由坍塌与负载不均是常见工程坑。文章讲清 top-k 显式路由的局限,以及 z-loss、蒸馏路由器冻结、潜空间路由、DeepSeek 动态偏置、共享专家五条稳定化路线的取舍与适用场景。
StableLatentMoE
MoE
大模型
架构
token
本地跑 LLM 的最短路径:Ollama 的安装、命令与边界
编程
本地跑 LLM 的最短路径:Ollama 的安装、命令与边界
2026-08-29 20:31:34
用 Go 写的 Ollama 在本地拉模型跑对话有多快,本文给出安装、run/pull/list/serve 常用命令、本地 HTTP API 与 OpenAI 兼容端点、GPU 与 Modelfile 用法,并明确什么情况下不该用它(高并发、完整 OpenAI 生态、复杂编排)。
Ollama
大模型
本地推理
Go
LLM
告别 Token 焦虑!手把手教你聚合免费大模型额度,OpenRouter / NVIDIA / Agnes 全搞定
资讯
告别 Token 焦虑!手把手教你聚合免费大模型额度,OpenRouter / NVIDIA / Agnes 全搞定
2026-08-26 15:23:53
作为AI应用开发者,最怕跑着跑着token没了。本文手把手教你用 freellmapi 聚合 OpenRouter、NVIDIA、Agnes 等平台的免费token额度,一个API Key打通所有免费大模型,实现模型切换与Token自由,告别Token焦虑。
AI工具
免费API
大模型
token
通义千问 Qwen3.8-27B 深度解析:Max 级旗舰权重首次开源,270 亿参数 Dense 模型如何在家用显卡上跑出旗舰性能
编程
通义千问 Qwen3.8-27B 深度解析:Max 级旗舰权重首次开源,270 亿参数 Dense 模型如何在家用显卡上跑出旗舰性能
2026-08-17 18:44:06
深度拆解阿里 Qwen3.8-27B:2.4T 旗舰与 27B 开源版的关系、MoE 架构细节、Dense 模型设计、vLLM/Ollama/昇腾部署实战、性能实测,以及完整的本地 RAG 代码示例。Apache 2.0 开源,家用显卡可跑。
Qwen3.8
通义千问
大模型
MoE
Dense架构
vLLM
Ollama
本地部署
后训练Scaling的工程奇迹:GLM-5.3 如何用同一基座把编程和网络安全能力推到开源第一
编程
后训练Scaling的工程奇迹:GLM-5.3 如何用同一基座把编程和网络安全能力推到开源第一
2026-08-17 11:48:04
深度拆解智谱GLM-5.3:同一7430亿参数基座,通过后训练Scaling将编程能力推至开源第一、CyberGym漏洞发现开源第一。全面覆盖IndexShare/SAO/Slime三层工程架构、多币种代码示例、安全漏洞审计演示与横向对比。
GLM-5.3
大模型
后训练Scaling
网络安全
漏洞发现
智谱AI
编程能力
开源模型
OpenAI Astra 踩刹车深度拆解:当AI模型触及网络安全“关键”阈值,Preparedness Framework 如何重写AI安全范式(2026)
编程
OpenAI Astra 踩刹车深度拆解:当AI模型触及网络安全“关键”阈值,Preparedness Framework 如何重写AI安全范式(2026)
2026-08-14 06:13:18
2026年8月7日 OpenAI 因自家 Preparedness Framework 触发 Critical 阈值暂停 Astra。本文从工程师视角拆解框架、五重防线,并给出可运行的 Agent 安全护栏代码与20条生产踩坑清单。
AI安全
大模型
Preparedness Framework
AI Agent
网络安全
OpenAI
沙箱隔离
纵深防御
DeepSeek V4 Pro 深度拆解:1.6万亿参数MoE与百万上下文,从 CSA/HCA 分层注意力到 Agent 实战的完整指南(2026)
编程
DeepSeek V4 Pro 深度拆解:1.6万亿参数MoE与百万上下文,从 CSA/HCA 分层注意力到 Agent 实战的完整指南(2026)
2026-08-13 23:12:57
深度拆解 DeepSeek V4 Pro:1.6万亿参数MoE、49B激活、CSA/HCA分层注意力、百万上下文成本结构、OpenAI/Anthropic双协议兼容与Agent代码实战,附15条生产踩坑清单。
DeepSeek V4 Pro
MoE
长上下文
Agent
大模型
OpenVINO 2026.3 深度拆解:从推理工具到「让大模型在 16GB 内存跑起来」的工程实践完全指南
编程
OpenVINO 2026.3 深度拆解:从推理工具到「让大模型在 16GB 内存跑起来」的工程实践完全指南
2026-08-13 08:43:23
深度拆解OpenVINO 2026.3:磁盘卸载让300亿MoE模型在16GB内存运行、懒加载权重降低内存峰值、HuggingFace Transformers 5.5兼容、GenAI新流水线、EAGLE-3推测解码扩展,配完整Python/C++代码示例与15条生产踩坑清单。
OpenVINO
AI推理
Intel
深度学习
模型部署
CPU推理
GPU推理
MoE
磁盘卸载
大模型
Qwen3.8深度拆解:2.4万亿参数稀疏MoE架构的技术革命,从模型设计到开源落地的全链路复盘
编程
Qwen3.8深度拆解:2.4万亿参数稀疏MoE架构的技术革命,从模型设计到开源落地的全链路复盘
2026-08-11 10:55:36
深度拆解阿里Qwen3.8的2.4万亿参数稀疏MoE架构:专家池设计、负载均衡、混合注意力机制、100万Token上下文、编程能力突破、开源生态影响与生产部署指南
Qwen3.8
大模型
MoE架构
稀疏激活
开源AI
千问
AI编程
深度学习
Transformer
Qwen3.8-Max 深度拆解:当阿里决定「用 2.4 万亿参数只激活 4%」——从稀疏 MoE 路由到混合注意力分层,一个 PaperBench 全球第一的旗舰模型如何用「极致稀疏化 + 自主进化」重新定义国产大模型的终极形态
编程
Qwen3.8-Max 深度拆解:当阿里决定「用 2.4 万亿参数只激活 4%」——从稀疏 MoE 路由到混合注意力分层,一个 PaperBench 全球第一的旗舰模型如何用「极致稀疏化 + 自主进化」重新定义国产大模型的终极形态
2026-08-06 06:42:51
深度拆解阿里Qwen3.8-Max旗舰大模型:2.4T MoE架构、混合注意力分层、16天自主编程、125小时论文复现,PaperBench全球第一的技术内幕
Qwen3.8-Max
MoE
混合注意力
大模型
阿里千问
AI Agent
PaperBench
自主编程
2026 LLM 推理框架深度拆解:当 vLLM 0.5 决定「让 PagedAttention 吞掉最后一块显存碎片」——从 PagedAttention 到 FlashAttention 3.0,四大推理框架如何用「算子融合 + 量化混合 + 动态批处理」重新定义大模型推理的终极形态
编程
2026 LLM 推理框架深度拆解:当 vLLM 0.5 决定「让 PagedAttention 吞掉最后一块显存碎片」——从 PagedAttention 到 FlashAttention 3.0,四大推理框架如何用「算子融合 + 量化混合 + 动态批处理」重新定义大模型推理的终极形态
2026-08-06 06:16:32
深度拆解2026年四大主流LLM推理框架:vLLM 0.5 PagedAttention进化、TGI 2.0流式输出优化、TensorRT-LLM 1.8算子融合、DeepSpeed-MII 0.9自动优化,含完整架构分析、代码实战、性能基准测试与成本计算
LLM
vLLM
TensorRT-LLM
推理框架
PagedAttention
量化
GPU
H100
大模型
DeepSpeed
TGI
Qwen3.8-Max 深度拆解:当阿里决定「把 2.4 万亿参数的 Max 模型开源」——从 MoE 架构到 16 天自主编程,一个首次开源的旗舰大模型如何用「激活 95B 跑出 2.4T 效果」重新定义开源模型的终极形态
编程
Qwen3.8-Max 深度拆解:当阿里决定「把 2.4 万亿参数的 Max 模型开源」——从 MoE 架构到 16 天自主编程,一个首次开源的旗舰大模型如何用「激活 95B 跑出 2.4T 效果」重新定义开源模型的终极形态
2026-08-05 18:47:19
深度拆解阿里Qwen3.8-Max:2.4万亿参数MoE旗舰,首次开源Max级权重,100万token上下文,16天自主编程oh-my-cli项目,Gated DeltaNet混合注意力架构,Arena全球第二,Apache 2.0完全可商用
Qwen3.8
Qwen
阿里
大模型
MoE
开源
人工智能
Apache 2.0
自主编程
oh-my-cli
DeepSeek V4-Flash 正式版深度拆解:284B MoE 架构如何用 13B 激活参数干翻自家 1.6T 旗舰——CSA+HCA 混合压缩注意力、Muon 优化器与 Agent 能力跃迁的全栈工程哲学
编程
DeepSeek V4-Flash 正式版深度拆解:284B MoE 架构如何用 13B 激活参数干翻自家 1.6T 旗舰——CSA+HCA 混合压缩注意力、Muon 优化器与 Agent 能力跃迁的全栈工程哲学
2026-08-03 19:12:41
深度拆解DeepSeek V4-Flash 284B MoE架构:CSA+HCA混合压缩注意力机制让1M上下文KV Cache降至V3.2的7%,Muon优化器替代AdamW,Agent能力跃迁至Terminal Bench 82.7分,13B激活参数推理成本仅0.88元/530万token,附完整部署代码与性能优化实战指南
DeepSeek
V4-Flash
MoE
CSA
HCA
Muon优化器
Agent
大模型
开源
Qwen3.8-Max 深度拆解:2.4万亿参数的MoE巨兽如何重新定义大模型天花板——从稀疏混合专家到1M上下文的全栈架构哲学
编程
Qwen3.8-Max 深度拆解:2.4万亿参数的MoE巨兽如何重新定义大模型天花板——从稀疏混合专家到1M上下文的全栈架构哲学
2026-08-03 17:14:27
深度拆解Qwen3.8-Max 2.4万亿参数MoE大模型架构:稀疏混合专家路由机制、混合注意力1M上下文、GQA KV Cache优化、量化部署实战、vLLM推理优化,附完整代码示例与性能基准分析
Qwen3.8
MoE
大模型
阿里巴巴
通义千问
混合专家
1M上下文
稀疏注意力
量化部署
vLLM
开源
DeepSeek V4 架构全拆解:MLA 压缩、MoE 动态路由与 1.6T 参数的工程哲学——从训练到推理的全栈重构
编程
DeepSeek V4 架构全拆解:MLA 压缩、MoE 动态路由与 1.6T 参数的工程哲学——从训练到推理的全栈重构
2026-08-03 00:13:26
深度拆解 DeepSeek V4 四大核心架构创新:MLA 16x KV Cache 压缩、MoE-Routing v2 Token级动态路由、HAAA混合注意力、antirez ds4.c推理引擎,附完整代码示例与生产部署指南
DeepSeek
MoE
MLA
KV Cache
大模型
AI推理
开源
性能优化
混合注意力
量化
Kimi K3 深度拆解:2.8万亿参数开源MoE旗舰的架构革命与工程极限
编程
Kimi K3 深度拆解:2.8万亿参数开源MoE旗舰的架构革命与工程极限
2026-07-31 09:42:32
深度拆解 Kimi K3 的三项核心架构创新:KDA 混合线性注意力、Attention Residuals、Stable LatentMoE。涵盖 O(n) 长上下文建模原理、极端稀疏 MoE 工程实践、FlashKDA 高性能 CUDA 优化、MoonEP 通信库,以及 2.8T 参数的显存墙分析与 Ollama/vLLM 本地部署指南。
Kimi K3
Moonshot AI
MoE
大模型
开源
KDA
Attention Residuals
Stable LatentMoE
深度学习
编程Agent
2.8万亿参数的开源大模型工程极限:Kimi K3 架构深度拆解与本地部署完全指南
编程
2.8万亿参数的开源大模型工程极限:Kimi K3 架构深度拆解与本地部署完全指南
2026-07-30 22:15:48
深度拆解 Kimi K3 的 2.8T MoE 架构:KDA 线性注意力、Attention Residuals、Stable Latent MoE、Benchmark 分析与完整本地部署指南
大模型
MoE
混合注意力
Kimi
开源AI
本地部署
Kimi K3 深度拆解:2.8 万亿参数开放权重,KDA 线性注意力与 896 专家稀疏路由如何撑起 100 万 token 上下文
编程
Kimi K3 深度拆解:2.8 万亿参数开放权重,KDA 线性注意力与 896 专家稀疏路由如何撑起 100 万 token 上下文
2026-07-30 05:44:46
深度拆解月之暗面开源的 Kimi K3:2.8T 参数 Stable Latent MoE(896选16)、KDA 混合线性注意力、AttnRes 与 MXFP4 量化训练,附玩具级代码实现、1M 上下文整库审查实战与冷静的成本边界分析。
Kimi K3
开放权重
MoE
线性注意力
KDA
长上下文
大模型
MXFP4
AI Agent
开源
Kimi K3 深度拆解:2.8 万亿参数、前端代码全球第一,国产大模型凭什么在「算力内卷」时代杀出重围
编程
Kimi K3 深度拆解:2.8 万亿参数、前端代码全球第一,国产大模型凭什么在「算力内卷」时代杀出重围
2026-07-28 07:17:15
深度拆解月之暗面 Kimi K3:2.8万亿参数MoE架构、前端代码全球第一、100万token长上下文,KDA混合线性注意力+AttnRes残差+Mooncake分离式推理三大技术创新,附完整API接入实战与生产落地指南。
Kimi K3
大模型
MoE
KDA
长上下文
前端代码
开源
国产AI
月之暗面
Claude Opus 5 深度解析:Anthropic 的「性价比革命」与 AI 编程新范式
编程
Claude Opus 5 深度解析:Anthropic 的「性价比革命」与 AI 编程新范式
2026-07-26 16:13:27
2026年7月25日Anthropic发布Claude Opus 5,性能逼近旗舰Fable 5但价格减半。本文深度解析其基准测试数据、AI编程实战能力、安全性争议、Multi-Agent协作潜力及开发者接入指南。
AI
Claude
Anthropic
AI编程
大模型
评测
OmniRoute深度拆解:500+模型统一调度、AI编程工具全家桶接入——开源AI网关的工程革命
编程
OmniRoute深度拆解:500+模型统一调度、AI编程工具全家桶接入——开源AI网关的工程革命
2026-07-24 11:12:42
深度拆解 GitHub 23k+ Star 的 OmniRoute 开源 AI 网关:290+ Provider、500+ 模型统一调度,RTK+Caveman Token 压缩节省 15-95%,Quota 感知自动回退,Claude Code/Cursor/Codex 全家桶接入实战
OmniRoute
AI网关
大模型
Claude Code
Cursor
Token压缩
智能路由
开源
colibrì 深度拆解:1300行纯C代码驱动7440亿参数大模型——当「不可能」变成「只是慢」
编程
colibrì 深度拆解:1300行纯C代码驱动7440亿参数大模型——当「不可能」变成「只是慢」
2026-07-19 14:42:08
深度拆解 colibrì 项目:一位意大利开发者用 10 天、1300 行纯 C 代码,在 25GB 笔记本上运行 7440 亿参数大模型的工程全貌。涵盖 MoE 稀疏推理、NVMe 流式专家、MLA 注意力、MTP 推测解码等核心技术的完整解析。
C语言
MoE
大模型
NVMe
量化
GPU
深度学习
GLM-5.2
推理引擎
推测解码
Google AI Edge Gallery 深度拆解:当手机成为大模型的「离线战场」——从 LiteRT 推理引擎到端侧 GenAI 的工程全貌(2026)
编程
Google AI Edge Gallery 深度拆解:当手机成为大模型的「离线战场」——从 LiteRT 推理引擎到端侧 GenAI 的工程全貌(2026)
2026-07-18 12:44:38
深度拆解 Google AI Edge Gallery 开源项目:LiteRT 推理引擎架构、INT4 量化原理、多模态支持、模型转换实战、企业级落地场景,配完整 Kotlin 代码示例与性能优化指南。
Google AI Edge Gallery
LiteRT
端侧AI
大模型
Android
量化
多模态
离线推理
移动端部署
GenAI
大家都在搜索什么?
devops
易支付
一个官网+多少钱
统一接受回调
统一回调
python
sub
node
宝塔日志
mysql
shell
ElasticSearch
css
vue
api接口对接
2025
支付接口对接
go
php
php回调
上一页
1
2
3
4
5
下一页
共 5 页
到第
页
确定