程序员茄子
全部
编程
代码
资讯
案例
综合
联系我们
强化学习 相关技术文章
php
mysql
shell
go
vue
css
api接口对接
支付接口对接
域随机化:让真实世界只是策略见过的又一个变体
编程
域随机化:让真实世界只是策略见过的又一个变体
2026-09-08 07:13:29
不追求仿真完美对齐,而是把光照、摩擦、质量、噪声随机化得足够宽;三类随机化(视觉/动力学/延迟)代码示例,MuJoCo 几行 numpy 接上。
机器人
AI
仿真
强化学习
Microsoft Research 推出 Echoverse:为计算机使用 AI 代理构建深度演化的训练环境
编程
Microsoft Research 推出 Echoverse:为计算机使用 AI 代理构建深度演化的训练环境
2026-09-07 01:12:52
Microsoft Research 推出 Echoverse,为计算机使用 AI 代理构建深度演化的训练环境集合,核心理念是缩放保真度而非数量,针对代理实际缺乏的能力训练并随模型演进而演化,包含10个深度领域世界和2个能力世界(日期选择器、嵌套过滤器),强调深度比广度更重要。
Microsoft Research
Echoverse
AI代理
计算机使用
训练环境
强化学习
编程
microduck:会打滚、会自己爬起来的开源双足机器人
2026-08-30 19:17:50
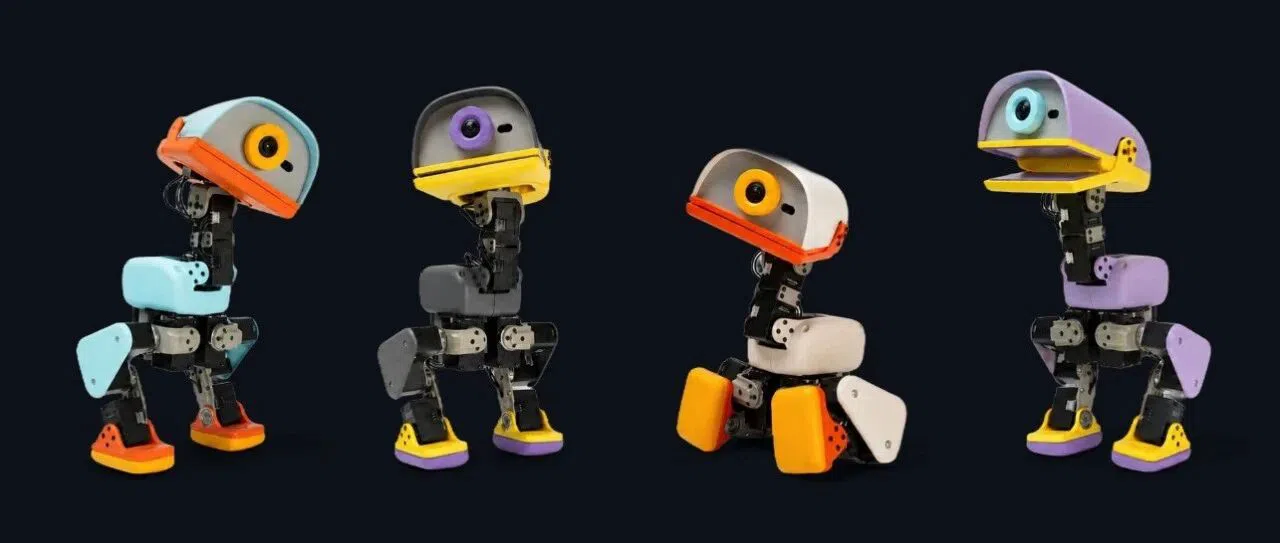
解析开源双足机器人 microduck:RK3566 主控 + 15 舵机,强化学习在仿真训练后导出 ONNX 端侧推理。讲清技术选型、控制频率、开源范围与适用边界,适合想复现或研究端侧 RL 的人参考。
microduck
双足机器人
强化学习
ONNX
端侧推理
RK3566
开源硬件
具身智能深度拆解:当 AI 走出屏幕、走进现实——从感知到行动的物理世界闭环全链路实战
编程
具身智能深度拆解:当 AI 走出屏幕、走进现实——从感知到行动的物理世界闭环全链路实战
2026-08-18 13:17:03
深度拆解 2026 年最热技术方向——具身智能(Physical AI/Embodied AI):从多模态感知、大模型任务规划、强化学习控制到生产部署的全链路实战,附完整 Python/ROS2/C++ 代码
具身智能
Physical AI
机器人
LLM任务规划
强化学习
力位混合控制
Isaac Gym
多模态感知
工业机器人
人形机器人
智能制造
机器臂控制
AgentENV 深度实战:Firecracker microVM 如何给每个 AI Agent 发一台真正隔离的 Linux 虚拟机——从不可能三角到 16 路 Fork 全链路拆解
编程
AgentENV 深度实战:Firecracker microVM 如何给每个 AI Agent 发一台真正隔离的 Linux 虚拟机——从不可能三角到 16 路 Fork 全链路拆解
2026-08-17 17:48:54
深度拆解 AgentENV:Moonshot AI 与 kvcache-ai 联合出品的 Agentic RL 执行环境平台。基于 Firecracker microVM 实现硬件级隔离,通过增量快照实现 50ms 环境恢复,通过 16 路 Fork 实现高效并行探索,配完整代码与生产调优指南。
AgentENV
Firecracker
microVM
AI Agent
沙箱隔离
快照
Fork
overlaybd
ublk
Agentic RL
Kimi K3
强化学习
Rust
VMM
Unsloth 深度实战:Triton 内核 + 手写反向传播引擎如何把 LLM 微调速度拉高 10 倍——从 LoRA 原理到 GRPO 强化学习全链路拆解
编程
Unsloth 深度实战:Triton 内核 + 手写反向传播引擎如何把 LLM 微调速度拉高 10 倍——从 LoRA 原理到 GRPO 强化学习全链路拆解
2026-08-16 09:15:16
深度拆解 Unsloth 框架如何用 Triton 内核 + 手写反向传播引擎把 LLM 微调速度提升 10 倍:从 LoRA/QLoRA 数学原理、算子融合、GRPO 强化学习到生产部署全链路实战,附完整代码示例与性能对比数据。
Unsloth
LoRA
Triton
LLM微调
GRPO
QLoRA
强化学习
GPU优化
命令行是 AI Agent 的「高考」:Terminal Bench 2.1 如何用真实任务测出模型上限
编程
命令行是 AI Agent 的「高考」:Terminal Bench 2.1 如何用真实任务测出模型上限
2026-08-15 17:16:04
深度拆解2026年最权威AI Agent评测体系Terminal Bench 2.1:用真实终端任务替代静态题库,从规划能力、工具选择、错误处理等五大维度全面评估Agent水平
Terminal Bench
AI Agent
评测基准
模型评估
LLM
强化学习
Shell
命令行
Terminal Bench 2.1 深度拆解:当「用命令行执行真实任务」成为衡量 AI Agent 能力的黄金标准——2026 评测体系全解析
编程
Terminal Bench 2.1 深度拆解:当「用命令行执行真实任务」成为衡量 AI Agent 能力的黄金标准——2026 评测体系全解析
2026-08-15 17:15:05
深度拆解2026年最权威AI Agent评测体系Terminal Bench 2.1:从真实终端任务设计、沙箱安全机制到五大核心维度评分,配代码示例与行业数据
Terminal Bench
AI Agent
评测基准
模型评估
LLM
强化学习
Shell
命令行
Agent Lightning 深度拆解:当强化学习成为 AI Agent 的「进化引擎」——零代码接入 RL 训练的生产级实战指南
编程
Agent Lightning 深度拆解:当强化学习成为 AI Agent 的「进化引擎」——零代码接入 RL 训练的生产级实战指南
2026-08-15 09:16:12
深度拆解微软Agent Lightning项目:训练-代理分离架构、三要素设计、生产级部署避坑指南,零代码接入RL训练让AI Agent越用越聪明
Agent Lightning
强化学习
AI Agent
微软
RL
PPO
生产级AI
模型优化
Agent Lightning 深度拆解:当强化学习遇上 AI Agent——从「零代码变更」到多智能体协同进化的生产级实战指南(2026)
编程
Agent Lightning 深度拆解:当强化学习遇上 AI Agent——从「零代码变更」到多智能体协同进化的生产级实战指南(2026)
2026-08-14 07:45:23
深度拆解微软开源 Agent Lightning 框架:从零代码变更架构到多智能体协同优化,从 LangChain/AutoGen/CrewAI 集成到 Reward 设计与收敛调试,配完整代码实战与 15 条生产踩坑清单。
Agent Lightning
强化学习
AI Agent
微软
开源框架
PPO
GRPO
LangChain
AutoGen
多智能体
SkillOpt 深度拆解:当微软决定「像训练神经网络一样训练 Skill」——从轨迹驱动优化到文本空间搜索,一个 3.1K Star 的框架如何用「不改权重只改文档」重新定义 Agent 技能优化的终极形态
编程
SkillOpt 深度拆解:当微软决定「像训练神经网络一样训练 Skill」——从轨迹驱动优化到文本空间搜索,一个 3.1K Star 的框架如何用「不改权重只改文档」重新定义 Agent 技能优化的终极形态
2026-08-05 21:49:06
深度拆解微软开源的SkillOpt框架:用训练神经网络的方法论优化Agent技能文档,不改权重只改Markdown,52个评测组合全部最优,准确率提升20%+
SkillOpt
微软
AI Agent
技能优化
LLM
Prompt工程
强化学习
轨迹优化
文本空间搜索
开源
LLaDA2.2 深度拆解:全球首个大规模 Agentic 扩散模型——Levenshtein 编辑 + L-EBPO 如何打破自回归垄断
编程
LLaDA2.2 深度拆解:全球首个大规模 Agentic 扩散模型——Levenshtein 编辑 + L-EBPO 如何打破自回归垄断
2026-07-31 10:46:00
全球首个大规模 Agentic 扩散模型深度拆解,详解 Levenshtein 编辑范式、L-EBPO 强化学习算法与 BlockRouting 128K 长上下文工程实践,对比自回归模型 Agent 能力评测。
扩散语言模型
Agentic AI
Levenshtein编辑
L-EBPO
蚂蚁集团
MoE架构
128K上下文
开源模型
AI Agent
强化学习
Hermes Agent 深度拆解:当 AI 学会「自我进化」——从动态技能生成、三层记忆架构到强化学习闭环的工程全貌(2026)
编程
Hermes Agent 深度拆解:当 AI 学会「自我进化」——从动态技能生成、三层记忆架构到强化学习闭环的工程全貌(2026)
2026-07-18 07:15:45
深度拆解 Hermes Agent:21.6万 Stars 的自进化 AI Agent 框架。从动态技能生成、三层记忆架构(Built-in/External/Session)、ACP 跨 Agent 通信协议到 GRPO 强化学习闭环的完整工程全貌,配代码实战与部署指南。
Hermes Agent
AI Agent
自进化
记忆系统
强化学习
GRPO
ACP协议
Nous Research
Hermes Agent 深度拆解:当 AI Agent 学会「自我进化」——闭环学习、Blackboard 架构与 GRPO 强化学习的工程全貌
编程
Hermes Agent 深度拆解:当 AI Agent 学会「自我进化」——闭环学习、Blackboard 架构与 GRPO 强化学习的工程全貌
2026-07-17 00:45:44
深度拆解 Hermes Agent:闭环学习系统、三层记忆架构、Blackboard 协作范式、GRPO 强化学习与自动技能生成,配完整代码示例与生产部署指南。
Hermes Agent
AI Agent
自进化
闭环学习
GRPO
Blackboard架构
强化学习
NousResearch
智谱 slime 深度实战:当 RL 后训练终于有了工业级「炼丹炉」——从 Megatron+SGLang 三模块联调到 GLM-5.2 两天完成 OPD 后训练的生产级完全指南(2026)
编程
智谱 slime 深度实战:当 RL 后训练终于有了工业级「炼丹炉」——从 Megatron+SGLang 三模块联调到 GLM-5.2 两天完成 OPD 后训练的生产级完全指南(2026)
2026-06-23 07:54:24
2026年6月智谱开源RL后训练框架slime,支撑GLM-5.2仅用2天完成OPD后训练。本文深度解析其三模块架构、原生引擎透传设计、PD分离、增量权重同步等核心技术,附完整生产级部署实战代码。
强化学习
RL训练
slime框架
智谱AI
GLM-5.2
Megatron
SGLang
后训练
开源框架
生产级部署
MusaCoder 深度实战:当国产GPU遇见AI驱动的Kernel生成——从PyTorch到CUDA/MUSA原生算子的全栈训练完全指南(2026)
编程
MusaCoder 深度实战:当国产GPU遇见AI驱动的Kernel生成——从PyTorch到CUDA/MUSA原生算子的全栈训练完全指南(2026)
2026-06-16 06:47:47
MusaCoder是首个基于国产GPU完成全链路训练的代码大模型,在KernelBench上超越Claude Opus 4.7。从三阶段数据合成、多样性RFT到执行反馈RL,深度解析全栈训练方法论。
MusaCoder
GPU Kernel
摩尔线程
国产GPU
CUDA
MUSA
大模型
强化学习
KernelBench
代码大模型
AI Coding
深度学习
Hermes Agent 深度实战:自进化 AI Agent 的三层记忆架构与 Skill 自动生成完全指南(下篇)
编程
Hermes Agent 深度实战:自进化 AI Agent 的三层记忆架构与 Skill 自动生成完全指南(下篇)
2026-06-04 04:45:35
下篇:深入讲解 Nudge Engine 定时复盘、强化学习从经验中学习、完整代码实战(从零搭建自进化 Agent)、与其他框架对比、生产级最佳实践、性能优化策略。
Hermes Agent
自进化
AI Agent
Nudge Engine
强化学习
代码实战
Stanford CS336 深度实战:从零实现大语言模型——数据清洗、Transformer 架构、FlashAttention 系统优化到 RL 对齐的完全指南(2026)
编程
Stanford CS336 深度实战:从零实现大语言模型——数据清洗、Transformer 架构、FlashAttention 系统优化到 RL 对齐的完全指南(2026)
2026-06-02 20:14:38
Stanford CS336 课程深度解读:从零实现大语言模型,覆盖 Tokenizer、Transformer、FlashAttention-2、FSDP 分布式训练、Scaling Law、Common Crawl 数据清洗去重、SFT 与 GRPO 对齐,配完整代码示例。
LLM
Transformer
Stanford CS336
FlashAttention
PyTorch
AI工程
分布式训练
强化学习
Microsoft Agent Lightning 深度实战:零代码变更强化学习——让 AI Agent 在真实交互中自我进化(2026 完全指南)
编程
Microsoft Agent Lightning 深度实战:零代码变更强化学习——让 AI Agent 在真实交互中自我进化(2026 完全指南)
2026-05-30 10:10:57
Microsoft Agent Lightning 深度解析:零代码变更强化学习框架,让AI Agent在真实交互中自我进化。涵盖架构原理、LightningRL算法、代码实战、信用分配机制与生产级部署。
Microsoft Agent Lightning
强化学习
AI Agent 训练
RL
零代码变更
Microsoft Agent Lightning 深度实战:零代码变更优化AI代理的强化学习完全指南(2026)
编程
Microsoft Agent Lightning 深度实战:零代码变更优化AI代理的强化学习完全指南(2026)
2026-05-24 15:00:19
深度解析Microsoft Agent Lightning框架,探讨如何通过零代码变更方式优化AI代理,包括架构分析、代码实战和性能优化
AI Agent
强化学习
微软开源
agent训练框架
RL训练
Agent-Lightning 深度实战:微软开源RL训练框架——零代码优化任意AI代理的生产级实践
编程
Agent-Lightning 深度实战:微软开源RL训练框架——零代码优化任意AI代理的生产级实践
2026-05-22 21:46:28
深度解析微软Agent-Lightning框架,实现零代码修改的AI Agent强化学习训练,解耦架构设计与生产实践
AI Agent
强化学习
微软
RL训练
Agent-Lightning
Microsoft Agent-Lightning 深度实战:零代码优化AI代理的训练框架——微软RL训练的革命性工具与生产级实践
编程
Microsoft Agent-Lightning 深度实战:零代码优化AI代理的训练框架——微软RL训练的革命性工具与生产级实践
2026-05-22 21:46:03
深度解析微软Agent-Lightning框架,实现零代码修改的AI Agent强化学习训练,解耦架构设计与生产实践
AI Agent
强化学习
微软
RL训练
Agent-Lightning
微软 Agent Lightning 深度实战:从零构建可进化的 AI Agent——强化学习训练框架的技术架构与生产级实践
编程
微软 Agent Lightning 深度实战:从零构建可进化的 AI Agent——强化学习训练框架的技术架构与生产级实践
2026-05-22 09:48:50
微软开源的Agent Lightning框架深度解析:零代码变更即可对LangChain、AutoGen、CrewAI等主流Agent框架进行强化学习训练,支持PPO、自动Prompt优化和分布式训练
Agent Lightning
强化学习
AI Agent
LangChain
微软
MCP
RL
Agent Lightning 深度实战:微软开源的零代码 AI 代理训练框架——Triplet 与 VERL 算法详解
编程
Agent Lightning 深度实战:微软开源的零代码 AI 代理训练框架——Triplet 与 VERL 算法详解
2026-05-21 21:51:08
深度解析微软开源的 Agent Lightning (AGL) 框架,通过"零代码变更"理念,让开发者可以在不修改现有代理逻辑的情况下,使用强化学习、自动提示优化和监督微调等技术优化 AI 代理。
AI Agent
强化学习
Microsoft
Agent Lightning
提示工程
大家都在搜索什么?
devops
易支付
一个官网+多少钱
统一接受回调
统一回调
python
sub
node
宝塔日志
mysql
shell
ElasticSearch
css
vue
api接口对接
2025
支付接口对接
go
php
php回调
上一页
1
2
下一页
共 2 页
到第
页
确定